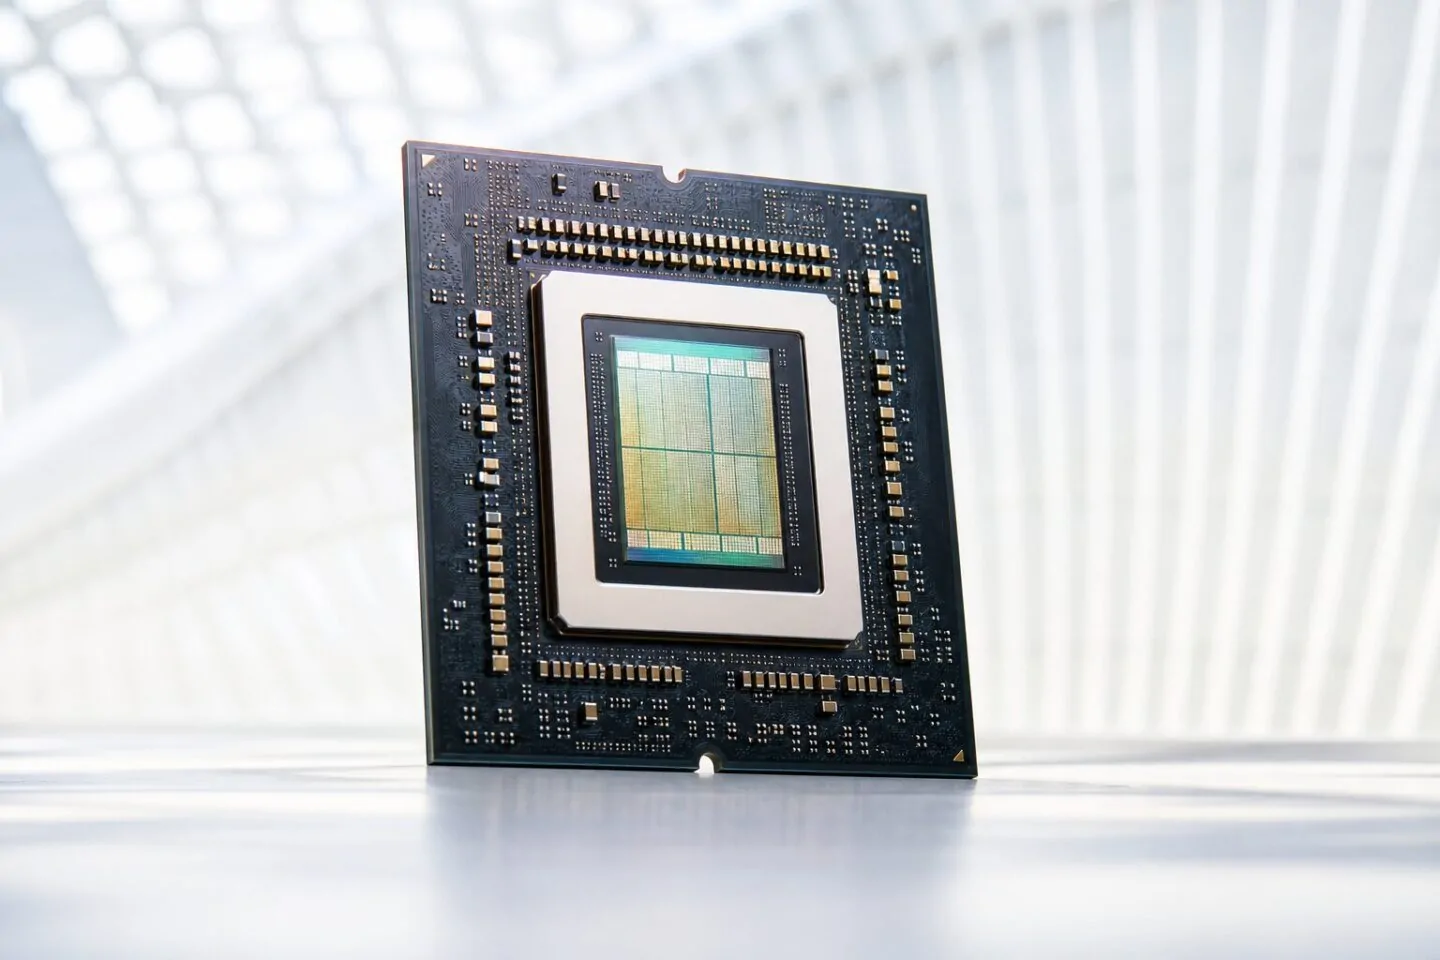
OpenAI ha il suo primo chip. Si chiama Jalapeño, è stato sviluppato insieme a Broadcom e il 24 giugno 2026 ne è stato consegnato fisicamente il primo esemplare ai vertici delle due aziende. Sam Altman e Greg Brockman lo hanno ricevuto dalle mani di Hock Tan, CEO di Broadcom. Non è un gesto simbolico: è l’inizio di una strategia hardware che OpenAI inseguiva da anni.
Jalapeño è un ASIC — un circuito integrato per applicazioni specifiche — progettato esclusivamente per l’inferenza dei modelli linguistici di grandi dimensioni. Non gestisce training, non è flessibile come una GPU, non è pensato per uso generico. Fa una cosa sola: eseguire LLM dopo che sono stati addestrati, nel modo più efficiente possibile. Gli ingegneri di OpenAI hanno costruito l’architettura attorno ai pattern reali di accesso alla memoria, al movimento dei dati e ai comportamenti di rete dei propri modelli. I campioni di ingegneria già in laboratorio girano carichi di lavoro reali, tra cui GPT-5.3-Codex-Spark, a frequenza e potenza di produzione target. I test preliminari mostrano performance per watt superiori all’attuale stato dell’arte, secondo quanto dichiarato da OpenAI stessa, anche se i benchmark definitivi arriveranno nei prossimi mesi.
Il chip è passato dal primo progetto al tape-out in nove mesi. Un tempo straordinariamente breve per un ASIC ad alte prestazioni: normalmente il ciclo dura da un anno e mezzo a due anni. A contribuire alla velocità, tre fattori: la co-progettazione software-hardware tra i team di OpenAI e Broadcom, la capacità manifatturiera di quest’ultima, e l’uso dei modelli di OpenAI stessi per accelerare parti della progettazione e ottimizzazione del chip. La produzione fisica è affidata a TSMC, lo stesso fondatore che produce chip per Apple, AMD e Nvidia. L’assemblaggio di rack e sistemi è gestito da Celestica. Il primo deployment nei data center è previsto entro fine 2026, con Microsoft tra i partner principali, a scala di gigawatt.
La mossa ha una logica economica precisa. L’inferenza — il processo di risposta a ogni singola richiesta utente — avviene miliardi di volte al giorno su ChatGPT, Codex e le API di OpenAI. Il CEO di Broadcom, Hock Tan, ha stimato che Jalapeño possa garantire un risparmio sui costi di circa il 50% rispetto alle GPU convenzionali per uso inferenziale, sebbene nessun benchmark pubblico indipendente sia ancora disponibile. OpenAI era fino a oggi l’unico grande laboratorio AI senza silicio proprietario: Google ha i suoi TPU da oltre un decennio, Amazon ha Trainium, Microsoft ha Maia, Meta ha la serie MTIA. Questa dipendenza totale da Nvidia si traduceva in costi di fornitura elevati, tempi di consegna lunghi e scarsa leva contrattuale. Jalapeño non chiude quel rapporto — Nvidia resterà centrale per il training — ma sposta il controllo su una parte del flusso operativo che OpenAI esegue continuamente.
Per Nvidia il segnale è chiaro, anche se la minaccia nel breve termine è limitata. Il dominio nel training e l’ecosistema CUDA restano difficili da scalfire. Ma la quota di mercato nei chip AI è già scesa sotto il 70% con la crescita del silicio personalizzato. Se Jalapeño manterrà le promesse in produzione, e se OpenAI deciderà di rendere il chip disponibile ad altri sviluppatori LLM — come suggerisce il suo design flessibile — il mercato dell’inferenza potrebbe riallinearsi attorno a un’architettura nata direttamente dall’esperienza di chi quei modelli li ha costruiti.