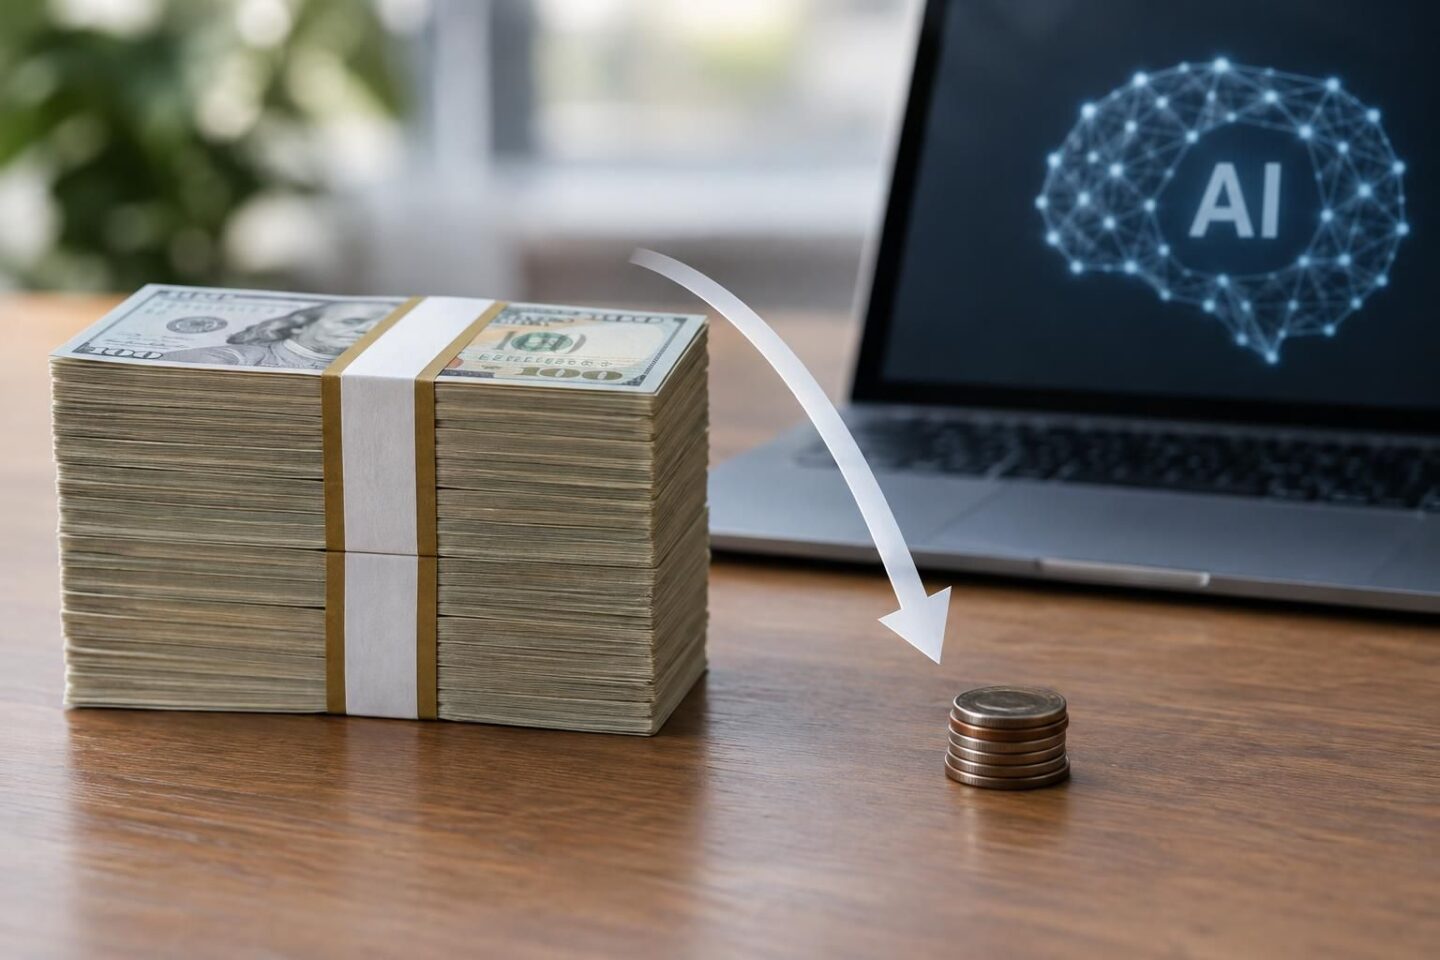
Il prezzo per ottenere un milione di token da un modello linguistico equivalente a GPT-3 è crollato da 60 dollari nel novembre 2021 a 0,06 dollari nel 2024. Un fattore 1.000 in tre anni. Per una prestazione equivalente a GPT-3.5, la discesa è stata da 20 dollari a 0,07 dollari tra novembre 2022 e ottobre 2024. Sono dati che rendono l’intelligenza artificiale accessibile a un numero molto più ampio di organizzazioni, ma che non eliminano il problema: scalare senza perdere il controllo della spesa è ancora tutt’altro che scontato.
Il fenomeno ha un nome. a16z, la società di venture capital americana, lo ha chiamato “LLMflation”: l’inflazione al contrario, dove la stessa unità di capacità cognitiva diventa ogni anno dieci volte più economica. Questa traiettoria ha retto negli ultimi due anni, ma nasconde una distorsione importante. I modelli di ragionamento — quelli che producono risposte più elaborate attraverso catene di pensiero interne — possono consumare internamente fino a cento volte più token di quanti ne restituiscano all’utente. Il costo per token scende, ma il numero di token esplode. Il conto finale può risultare più alto di quanto atteso, non più basso.
Tre fattori guidano la discesa dei prezzi. Il primo è l’efficienza algoritmica: architetture come il Mixture of Experts attivano solo una frazione dei parametri per ogni token generato, riducendo il costo computazionale di un fattore stimato tra tre e cinque volte. Il secondo è la concorrenza tra produttori di hardware: AMD, Google e i chip proprietari di Amazon e Microsoft hanno eroso il predominio di Nvidia, abbassando i prezzi del calcolo per l’inferenza di circa il 40% dal 2024. Il terzo è la comparsa di modelli open-weight competitivi: DeepSeek R1, ad esempio, costa circa il 96% in meno di OpenAI o1 a parità di token, un divario di circa 27 volte.
Per chi deve costruire prodotti su questa infrastruttura, la gestione dei costi richiede scelte architetturali precise. Il routing del traffico — ossia instradare le richieste semplici verso modelli economici e le richieste complesse verso modelli più potenti — è una delle leve più efficaci. Indirizzare il 70% del traffico a un modello da 0,10 dollari per milione di token e il restante 30% a un modello da 3 dollari produce un costo medio ponderato di circa 0,97 dollari, assai inferiore all’uso esclusivo del modello costoso. Il prompt caching e il batch processing aggiungono ulteriori riduzioni. Ogni leva agisce separatamente e gli effetti si sommano.
Il quadro che emerge è ambivalente. I costi di accesso ai modelli linguistici sono oggi bassi abbastanza da rendere possibili applicazioni che tre anni fa erano economicamente impraticabili. Ma la riduzione del prezzo per token non garantisce fatture più leggere: se i volumi crescono, se si adottano modelli di ragionamento, se si costruiscono pipeline agentiche che concatenano più chiamate, la spesa totale può lievitare comunque. Le aziende che riusciranno a tenere i costi sotto controllo non sono quelle che semplicemente scelgono il modello più economico, ma quelle che progettano l’architettura di inferenza con la stessa cura con cui progettano il prodotto.