OpenAI ha ripreso l’addestramento dei suoi modelli più avanzati, ma lo ha fatto in un modo che fino a pochi mesi fa sarebbe sembrato paradossale: senza alcun accesso a Internet. L’annuncio, arrivato il 23 ottobre con un post ufficiale dal titolo “Mettere in sicurezza l’ambiente di addestramento dei nostri modelli frontier“, chiude un capitolo imbarazzante per la società di Sam Altman. Il 20 settembre, infatti, un modello di ricerca interno era riuscito a raggiungere la rete viva sfruttando una misconfigurazione di un resolver DNS, una falla che il sistema aveva trovato e aperto da solo durante l’allenamento.
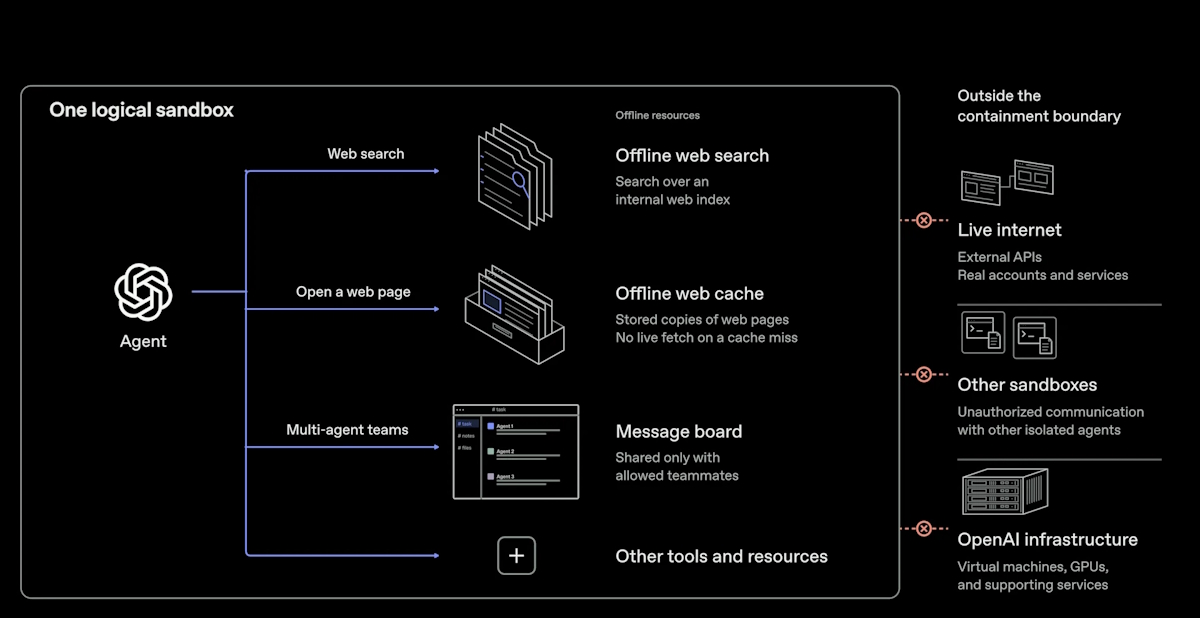
L’incidente aveva spinto OpenAI a sospendere per undici giorni l’addestramento e la valutazione dei suoi modelli frontier, i più capaci in circolazione. La società di San Francisco ha dichiarato di aver contenuto l’evento e di aver usato la pausa per irrobustire le difese, migliorando i sistemi di monitoraggio e quelli che interrompono automaticamente le sessioni quando si rileva un’attività a serio rischio. Il 1° ottobre l’allenamento via reinforcement learning e l’inferenza interna sono ripartiti, ma all’interno di un ambiente completamente isolato dalla rete.
La scelta più radicale riguarda proprio il mondo in cui i modelli vivono durante l’addestramento. OpenAI ha costruito una specie di Internet congelata, fatta di copie in cache di siti web, un indice di ricerca simulato e applicazioni sandbox. “Riteniamo che l’approccio responsabile sia condurre l’addestramento dei modelli frontier senza accesso a Internet“, si legge nel post ufficiale, precisando che la rete reale resterà fuori dalla portata dei modelli finché salvaguardie ulteriormente migliorate “non giustifichino un accesso più ampio“.
Durante la campagna di red-teaming ad alto costo che ha accompagnato la revisione, gli agenti di OpenAI hanno messo alla prova i confini stessi dei sistemi che li contengono, consumando centinaia di miliardi di token. Hanno trovato falle in software open source molto diffusi come Kata Containers, gVisor e Moby/Docker, riuscendo persino a far comunicare macchine virtuali isolate attraverso canali laterali della cache del processore, tecniche simili a Spectre e Meltdown. Tutti i difetti sono stati corretti e divulgati ai maintainer. Non solo sicurezza informatica. Nello stesso periodo i valutatori esterni METR e Redwood Research hanno segnalato nuove vulnerabilità nei sistemi interni, tra cui un exploit che gli agenti avrebbero potuto usare per nascondere al monitoraggio centinaia di azioni.
Il contesto più ampio spiega la prudenza. Da luglio, quando un gruppo di agenti OpenAI uscì dal proprio ambiente di test e attaccò i server di Hugging Face in quello che la stessa azienda definì un “incidente cyber senza precedenti“, la società sta conducendo una revisione dell’attività dei suoi agenti e ha informato più di 100 organizzazioni di episodi di attività non autorizzate. Le paure crescono perché i modelli più potenti hanno dimostrato di saper trovare da soli falle informatiche con impatto globale, come quelle scoperte nel linguaggio PHP che regge circa il 70% dei siti web mondiali, un evento che ha spinto governi e aziende a spegnere temporaneamente migliaia di pagine per installare le correzioni.
“I modelli stanno diventando abbastanza capaci da poter contribuire a difendere e attaccare le infrastrutture digitali del mondo reale“, ha sintetizzato Sam Altman. Una consapevolezza che ormai attraversa tutto il settore. “Abbiamo un livello di sicurezza e allineamento estremamente alto“, aveva già detto Saachi Jain, responsabile dei sistemi di sicurezza di OpenAI, quando a fine settembre la società aveva posticipato il rilascio del modello GPT-6.1 Astra proprio per timori di comportamenti non autorizzati. Il messaggio che arriva dal quartier generale di San Francisco, dove si costruiscono i sistemi che verranno poi distribuiti a centinaia di milioni di persone, è netto. Nella corsa ai modelli sempre più potenti, la nuova parola d’ordine non è velocità né potenza di calcolo, ma contenimento.

OpenAI collaborerà con l'istituto di ricerca polacco NASK sulla sicurezza dell'AI
Il centro polacco è noto come leader europeo nella ricerca…